
新区排队连接超时问题需系统排查,首先观察现象:玩家频繁掉线、登录延迟、队列卡顿,排查方向包括网络延迟、服务器负载、客户端异常及防火墙设置,解决方案涵盖优化网络环境、调整服务器配置、更新客户端版本、检查防火墙规则及联系官方客服,通过分步排查可精准定位问题根源,提升玩家体验。
在数字化服务高速发展的今天,各类网络平台、游戏服务器、企业级应用系统等纷纷推出"新区"以满足用户增长需求,新区开放初期常出现"排队连接超时"问题,不仅影响用户体验,还可能引发用户流失、系统稳定性下降等连锁反应,本文将从现象描述、原因分析、排查流程、解决方案、预防措施五大维度,系统阐述新区排队连接超时的常见问题排查方法,帮助运维人员、开发工程师及普通用户快速定位并解决问题。
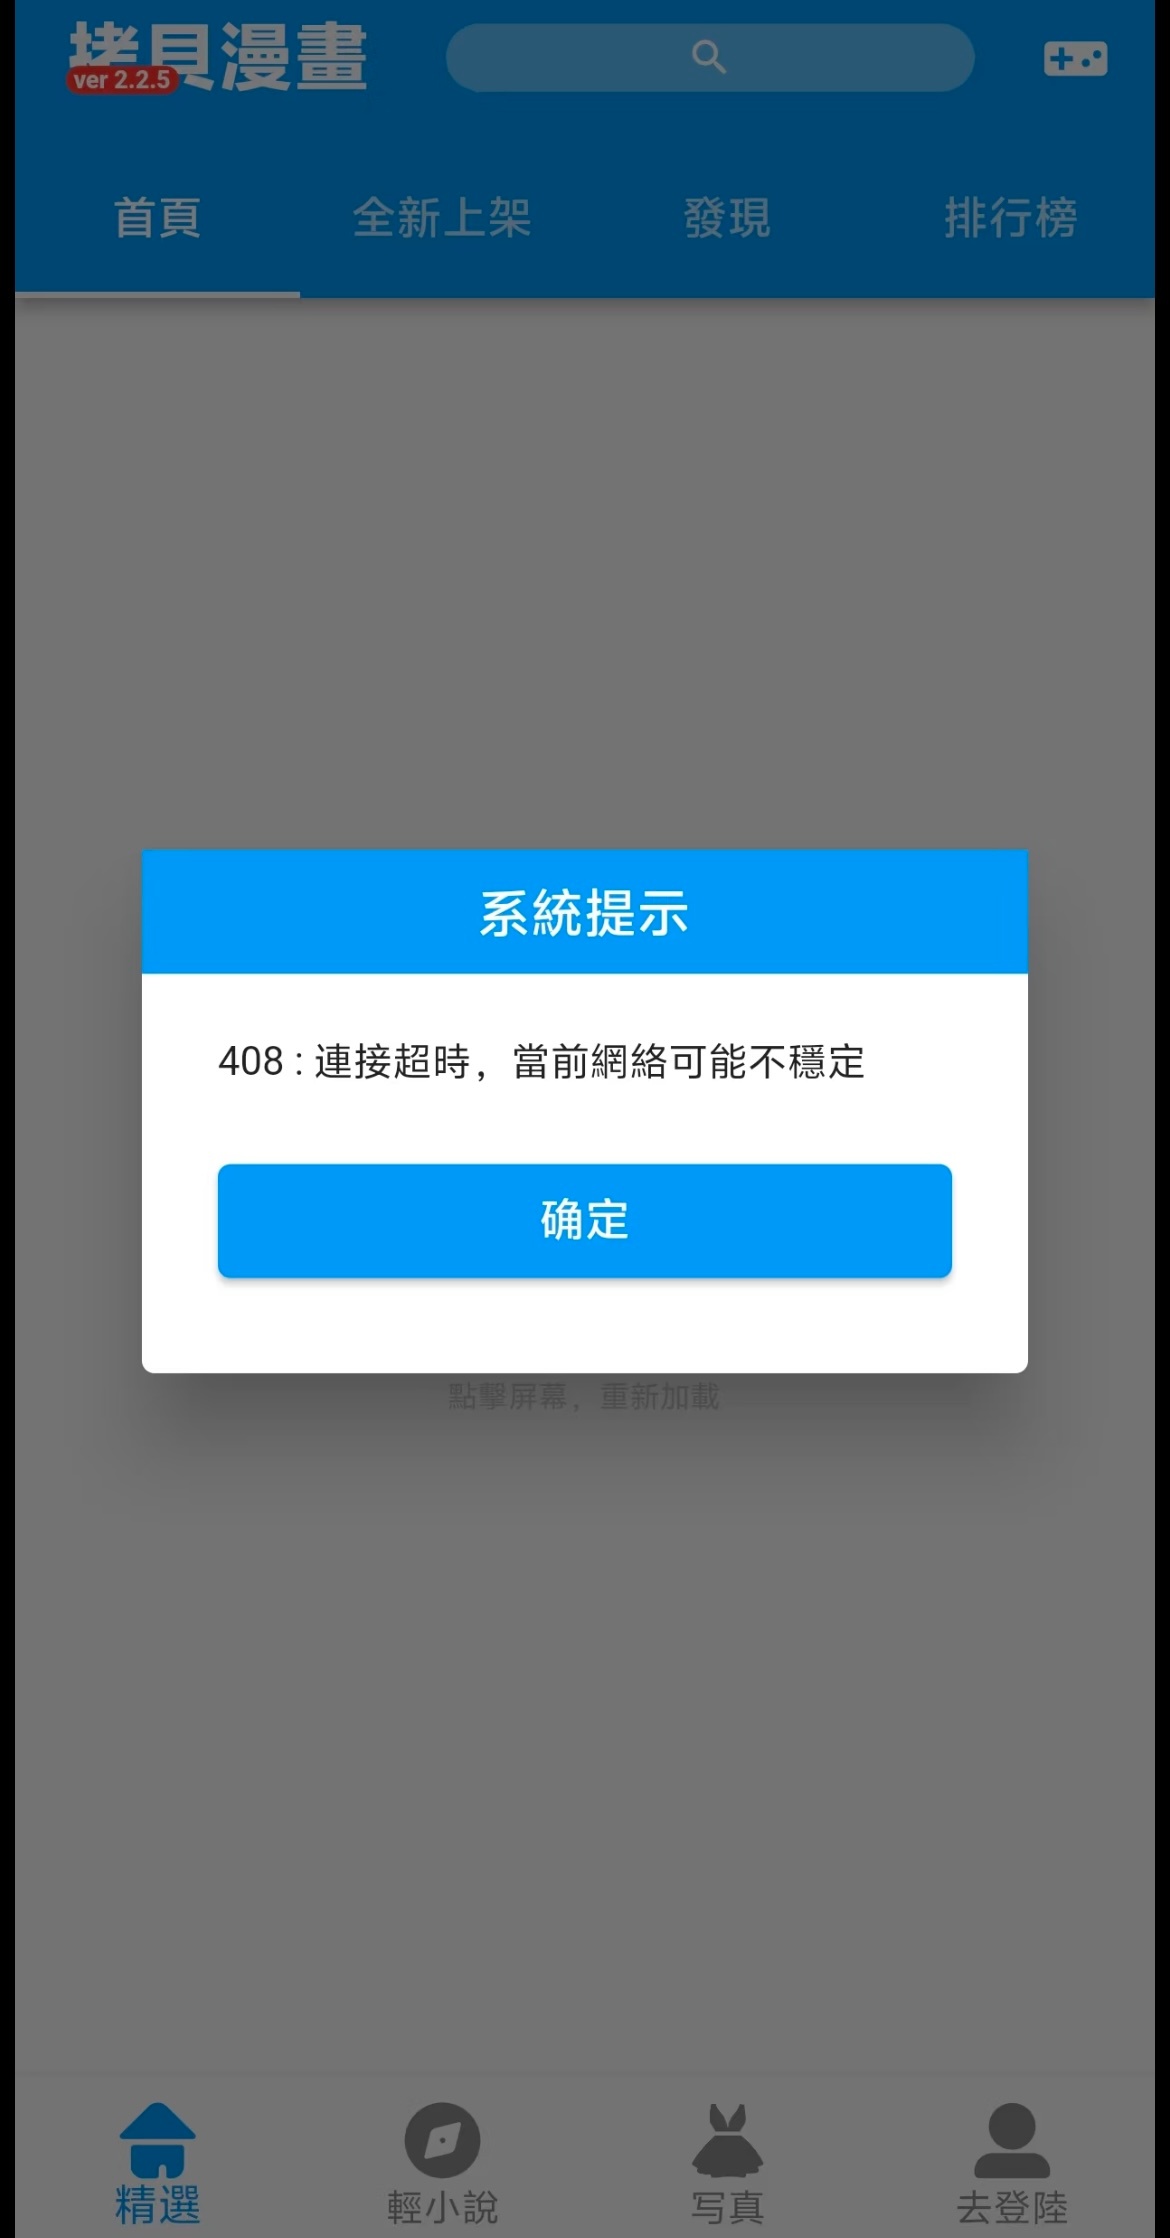
现象描述与影响范围 新区排队连接超时通常表现为:用户尝试进入新开放的服务器或服务区域时,系统提示"连接超时""排队人数过多""服务不可用"等错误信息,具体现象可能包括:
- 登录界面长时间卡顿在排队界面,预计等待时间不断跳动且无实质进展;
- 连接过程中出现间歇性断连,需反复重试;
- 部分用户成功进入后反映操作延迟严重,影响正常功能使用;
- 后台监控显示服务器CPU/内存使用率异常波动,网络带宽占用率突增;
- 日志文件中频繁出现"连接超时""请求超时""资源不足"等错误记录。
此类问题不仅直接影响用户体验,还可能造成品牌声誉损失、用户活跃度下降、潜在客户流失等长期负面影响,特别是在游戏、金融交易、在线教育等对实时性要求较高的场景中,连接超时问题可能导致直接经济损失。
常见原因深度剖析 新区排队连接超时的成因复杂多样,需从网络层、服务器层、应用层、资源层等多维度综合分析:
网络基础设施问题
- 骨干网带宽不足:新区开放瞬间流量激增,导致网络拥塞;
- DNS解析延迟:域名解析服务响应缓慢或配置错误;
- CDN节点故障:边缘节点缓存失效或回源策略不当;
- 防火墙/安全组配置过严:误拦截正常连接请求;
- 跨区域访问延迟:物理距离导致的网络传输延迟。
服务器资源瓶颈
- 计算资源不足:CPU/GPU负载过高导致请求处理延迟;
- 内存泄漏或不足:频繁触发垃圾回收影响性能;
- 磁盘I/O瓶颈:日志写入、数据库操作等引发存储延迟;
- 连接池配置不当:最大连接数设置过低或连接泄漏;
- 负载均衡策略失效:健康检查机制误判或流量分发不均。
应用架构与代码缺陷
- 初始化逻辑冗长:新区启动时加载大量资源导致响应延迟;
- 同步锁竞争激烈:多线程环境下资源争抢引发阻塞;
- 数据库查询效率低下:索引缺失或复杂JOIN语句导致响应超时;
- 缓存击穿/雪崩:热点数据未预热或缓存策略不当;
- 第三方服务依赖异常:支付、短信、身份验证等外部接口超时。
容量规划与资源分配
- 容量预估偏差:用户量预测与实际访问量差异过大;
- 弹性伸缩策略滞后:自动扩容机制响应延迟;
- 资源分配不均:不同服务器间负载差异显著;
- 预留资源不足:未考虑突发流量缓冲空间。
系统化排查流程 针对上述复杂成因,需建立科学的排查流程,遵循"由外到内、由浅入深"的原则:
基础环境检查
- 使用ping、traceroute等工具检测网络连通性;
- 通过telnet、nc等命令测试端口可达性;
- 对比不同地区、不同运营商的访问延迟;
- 检查本地DNS配置及公共DNS解析结果;
- 验证防火墙规则是否允许相关端口通信。
服务器状态监控
- 实时监控CPU、内存、磁盘、网络等系统指标;
- 使用top、htop、nmon等工具分析进程资源占用;
- 检查系统日志(如/var/log/messages)中的异常记录;
- 分析网络抓包数据(tcpdump、Wireshark)定位延迟环节;
- 对比正常时段与故障时段的监控数据差异。
应用层深度诊断
- 启用应用级日志追踪请求处理链路;
- 使用APM工具(如SkyWalking、Zipkin)进行全链路追踪;
- 分析慢查询日志定位数据库性能瓶颈;
- 检查缓存命中率及缓存穿透/击穿情况;
- 模拟并发请求进行压力测试验证系统容量。
架构级复盘验证
- 绘制系统架构图与流量路径图;
- 验证负载均衡算法是否生效;
- 检查服务注册发现机制是否正常;
- 评估熔断、降级、限流等保护机制是否触发;
- 复盘容量规划模型与实际用户行为的匹配度。
针对性解决方案 根据排查结果,可采取以下针对性措施:
紧急缓解措施
- 临时增加服务器实例应对突发流量;
- 调整连接超时阈值延长等待时间;
- 启用备用域名或CDN加速节点;
- 实施临时限流策略保护核心服务;
- 发布公告引导用户分时段访问。
长期优化方案
- 优化网络架构:引入智能DNS解析、多线BGP接入;
- 改造应用架构:采用微服务、无状态设计提升扩展性;
- 完善监控体系:部署全链路监控、智能告警系统;
- 实施自动化运维:建立CI/CD流水线、自动扩缩容机制;
- 优化数据库设计:添加索引、分区表、读写分离。
用户体验优化
- 设计友好的排队界面显示实时进度;
- 引入排队优先级策略(如VIP用户优先);
- 开发离线排队功能允许用户关闭页面后保留位置;
- 提供排队预计时间动态预测算法;
- 构建多维度通知系统(短信、APP推送、邮件)。
预防性措施与最佳实践 为避免同类问题再次发生,需建立长效预防机制:
容量规划体系
- 建立科学的容量评估模型;
- 定期进行全链路压力测试;
- 实施混沌工程验证系统韧性;
- 预留充足的弹性缓冲资源。
监控预警系统
- 部署多维监控指标体系;
- 配置智能阈值与异常检测算法;
- 建立自动化告警与响应流程;
- 开发可视化监控大屏实时展示系统状态。
架构演进策略
- 采用云原生架构提升弹性能力;
- 实施服务网格化增强治理能力;
- 引入Serverless架构降低运维复杂度;
- 构建多活数据中心保障业务连续性。
用户沟通机制
- 制定透明的服务状态公告策略;
- 建立用户反馈快速响应通道;
- 定期发布系统优化进展报告;
- 开展用户满意度调查持续改进。
新区排队连接超时问题是复杂的系统性挑战,需要从技术、架构、运维、用户体验等多维度综合施策,通过建立科学的排查流程、实施针对性的解决方案、构建长效的预防机制,可以有效提升系统稳定性与用户体验,在数字化转型加速的今天,掌握系统化的排查方法与优化策略,已成为运维人员与开发工程师的必备技能,唯有持续优化、主动预防,才能在激烈的市场竞争中赢得用户信赖,实现业务的长期稳健发展。


